こんにちは。Tradivanceです。
「社内の規程やマニュアルをAIに読ませて、質問に答えさせたい」。そう考えて調べるうちに、「RAG」という言葉にたどり着いた方もいるのではないでしょうか。
特に「RAGとは何か」「ChatGPTと何が違うのか」「何から始めればいいのか」と迷っている方も多いのではないでしょうか。
RAGは、生成AIが社内の文書などを探してから答える仕組みです。答えの質は、仕組みそのものより「元の文書」と「探し方」で大きく変わります。
仕組みだけを理解して製品選びに進むと、文書が古い、権限が整理されていないといった理由で、「思ったような答えが返ってこない」ということが起こります。
だからこそ本記事では、RAGの意味と仕組みを短く押さえたうえで、Gemini Notebook(旧 NotebookLM)などの手元の道具で試す方法と、効果の測り方までを整理します。
本記事で分かること
- RAG(検索拡張生成)の意味と、探す・足す・答えるの3段階
- 生成AI・ファインチューニングとの違いと、「学習」と「参照」の区別
- RAGが間違える4つの原因と対策
- 手元の道具で試す方法と、効果の測り方
RAGとは|生成AIが「調べてから答える」ための仕組み
RAG(ラグ)は Retrieval-Augmented Generation の略で、日本語では「検索拡張生成」と訳されます。生成AIが答える前に、社内の文書などから質問に関係する部分を探し、それを手がかりに答えを作る仕組みです。
例えば、同じ「結婚したときの特別休暇は何日もらえますか」という質問でも、普通の生成AIは「会社によって異なります」といった一般的な答えしか返せません。RAGを使うと、自社の就業規則から特別休暇の部分を探してから答えるので、「当社では5日です」のように自社のルールで答えが返ってきます。
総務省と経済産業省のAI事業者ガイドライン(第1.2版)別添は、企業での使われ方を「社内文書やデータベース等を検索し生成AIの回答の精度を高めることに使われている」と説明しています。
RAGの読み方と正式名
RAG(ラグ)= Retrieval-Augmented Generation = 検索拡張生成
- Retrieval:探して取り出すこと(検索)
- Augmented:付け足して強めること(拡張)
- Generation:文章を作ること(生成)
つまり「探して取り出した情報を付け足して、答えを作る」という意味で、次の章の3段階にそのまま対応しています。
RAGが必要になる理由|生成AIは社内のことを知らない
ChatGPTなどの生成AIは、Web検索を使わないときは、学習した時点までの情報で答えます。自社の就業規則や、先月改訂した手順書の中身は知りません。
それでも、知らないことをもっともらしく答えることがあります。AWSの解説は、この状態を「最新の出来事を把握しようとしないのに、どんな質問にも自信満々に答える、熱心すぎる新入社員」(当社訳)にたとえています。
RAGは、この新入社員に社内の規程集を手渡し、「ここを見てから答えて」と頼む仕組みだと考えると分かりやすいでしょう。
総務省の令和8年版 情報通信白書(2026年1〜2月調査)では、調査に回答した日本企業のうち24.5%(中小企業は17.7%)が「生成AIに社内データを学習させたり、生成AIが参照可能なデータベースを構築したりしている」と答え、米国・ドイツ・中国は5割を超えました。
ただしこの設問は「学習」と「参照」をまとめて聞いたもので、RAGだけの割合ではありません。
RAGという言葉の出どころ
名前と考え方の出どころは、2020年にFacebook AI Researchなどの研究者が発表した論文です。外部の知識を差し替えれば、世の中の変化に合わせてAIの知識を更新できると示し、国際会議NeurIPS 2020に採録されました。
ただし論文のRAGは、探す部品と答える部品をまとめて学習させる研究でした。今の製品でいうRAGは、AIを学習し直さず、探した結果を質問に足す形なので、作りが異なります。
RAGの仕組みをわかりやすく|探す・足す・答えるの3段階
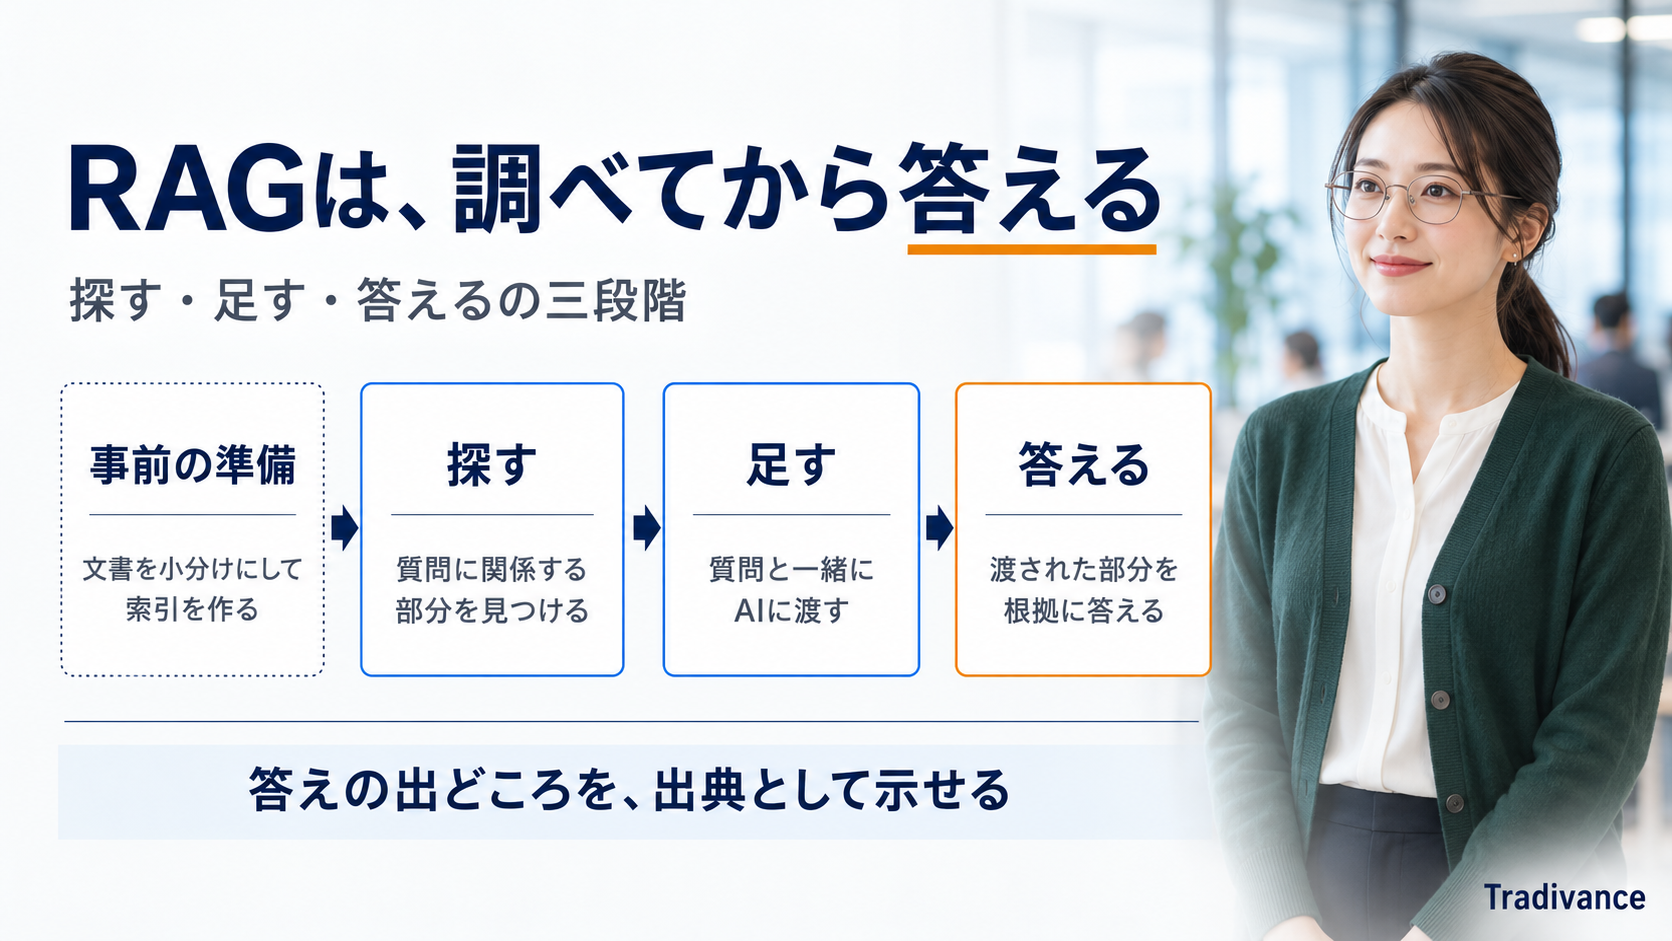
RAGの仕組みは「探す・足す・答える」の3段階です。Microsoftの解説も、Retrieve・Augment・Generateの3ステップで説明しています。
探す(Retrieve)
質問を受け取ると、あらかじめ作っておいた索引(検索用の目録)から、関係する文書の部分を探します。文書を丸ごとではなく、関係する部分だけを取り出します。
足す(Augment)
質問と、見つかった文書の部分を1つの依頼文にまとめて生成AIに渡します。「この資料をもとに答えて」と、資料を添えて頼む形です。
答える(Generate)
生成AIは、渡された部分を根拠に答えを作ります。どの文書のどこを使ったかを出典として示せるのが、RAGの大きな特徴です。
身近な例でいえば、規程集を手元に置いて問い合わせに答える総務担当の動きです。AWSの解説でも、「年次休暇はどのくらいあるのか?」という質問に対し、年次休暇の規程と本人の過去の休暇記録を探して答える例が挙げられています。
AWSは、文書が変わったら索引も更新する工程を仕組みに含めています。一度作って終わりではなく、文書の更新と一緒に回し続ける仕組みです。
事前の準備|文書を小分けにして、意味で探せるようにしておく
探す段階を支えるのが事前の準備です。長い文書を小分けにし、意味で探せる索引を作っておきます。
RAGの準備で出てくる用語
- チャンク:長い文書を、AIが扱える長さに小分けにした断片
- 埋め込み:文章の意味を数値に置き換えること。意味が近い文章ほど数値も近くなります
- ベクトル検索:数値の近さを使い、言葉が違っても意味が近い文書を探す方法
Microsoftは、英語の「dog(犬)」と「canine(イヌ科の動物)」のように、綴りが違っても意味が近い言葉を近いものとして扱える例を示しています。
また、意味の検索と、言葉の一致を見るキーワード検索を同時に使うと、片方だけより良い結果になることが多いとも説明しています。デジタル庁が2026年5月に報告した検証でも、マニュアルのチャットボットは2つを組み合わせたものです。
RAGと生成AI(LLM・ChatGPT)・ファインチューニングの違い
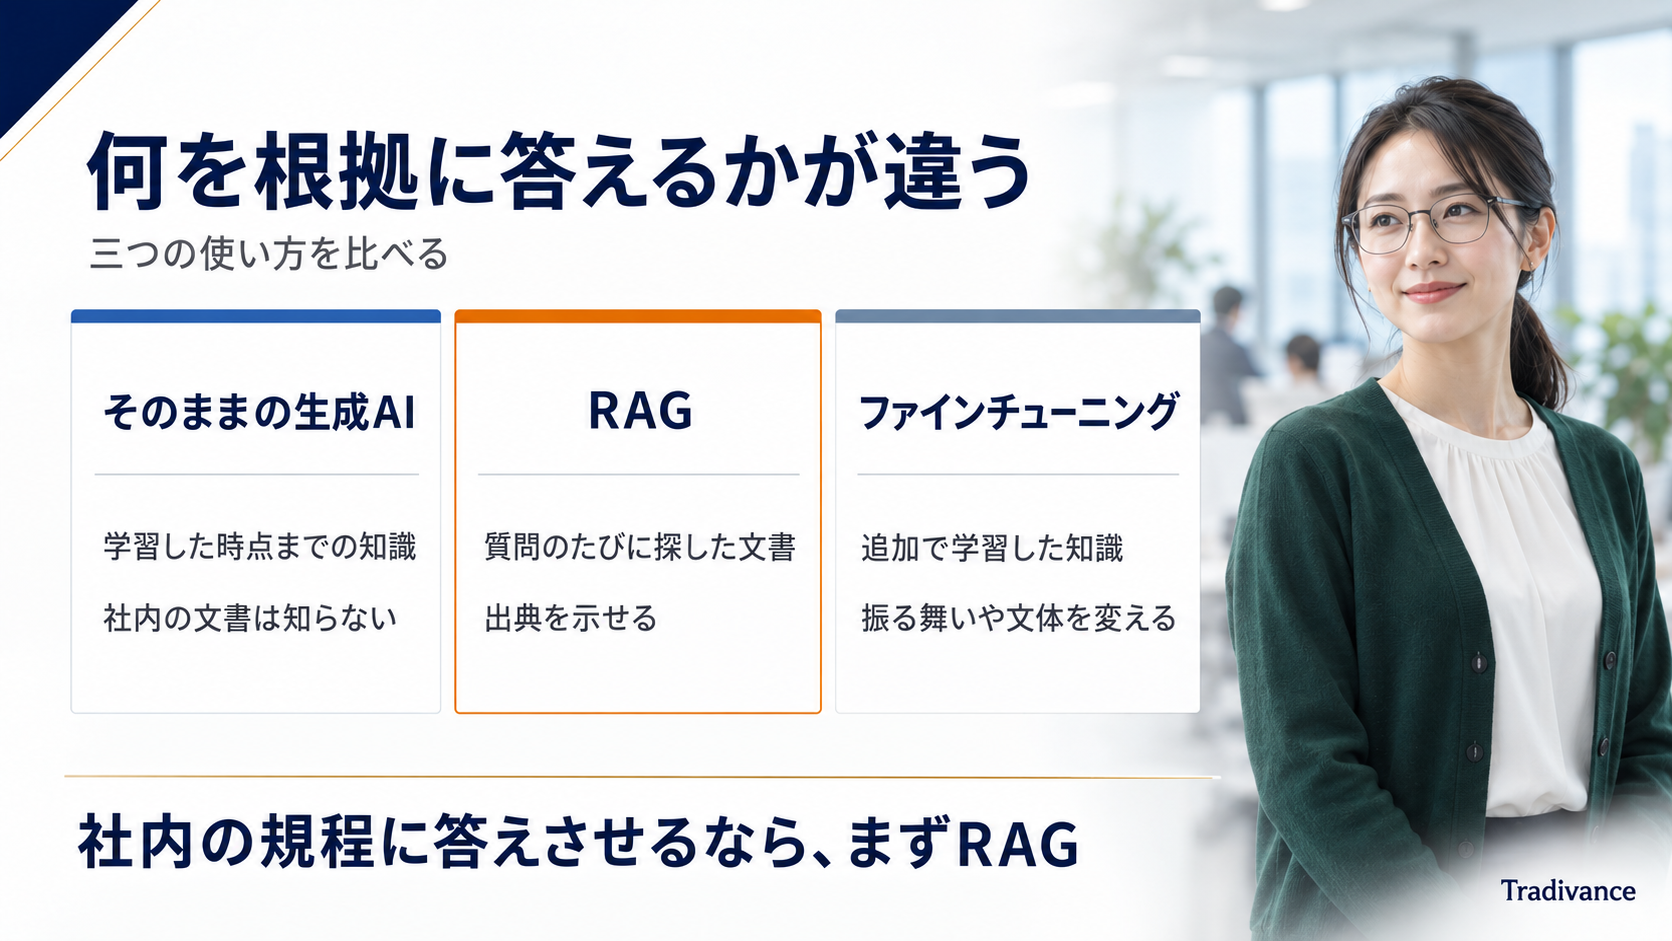
RAGは生成AIの代わりではなく、生成AIに「探す工程」を足した使い方です。ファインチューニングは、追加のデータでAIそのものを学習し直す方法で、目的が違います。
| 比べる点 | 素の生成AI | RAG | ファインチューニング |
|---|---|---|---|
| 何を根拠に答えるか | 学習した時点までの知識 | 質問のたびに探した文書 | 追加で学習したAI自身の知識 |
| 最新の情報 | 学習した時点まで(Web検索を使わないとき) | 文書を差し替えれば反映 | 学習し直すまで反映されない |
| 社内の文書 | 知らない | 探して使う | 学習させた範囲は反映 |
| 出典を示せるか | 示しにくい | 示せる | 示さない |
| 入れ替えの手間 | 入れ替えられない | 数分で取り込める | 数時間から数日 |
| 向く使い方 | 一般的な文章作成 | 社内の規程や、よく変わる情報にもとづく回答 | 振る舞いや文体を変える |
出典:Comparing RAG and fine-tuning(AWS)/Microsoft Learn
LLM・ChatGPTとRAGの違い|RAGは生成AIの「使い方」の一つ
LLM(大規模言語モデル)は、答えの文章を作る生成AIの中心の部品で、ChatGPTはLLMを使った会話のサービスです。RAGはLLMの前に「探す工程」を足した使い方で、答えを作るのはLLMのままになります。
ChatGPTにファイルを渡して質問する使い方も、渡した文書を手がかりに答える点でRAGに近い動きです。
普通の検索(キーワード検索)とも違います。検索は文書を並べるところまで、RAGは見つけた部分から答えの文章まで作ります。生成AIそのものの仕組みは、「生成AIとは何か?」で解説しているので、そちらをご覧ください。
RAGとファインチューニングの違いと使い分け
Microsoftは、非公開のデータや頻繁に変わるデータにもとづく答えが要るならRAG、振る舞いや文体を変えたいならファインチューニングと使い分けを示しています。
AWSも、ファインチューニングは数時間から数日かかり出典を示さない一方、RAGは数分で最新の文書を取り込み、出典を示すと比べています。そのため、自社の文書で質問応答を作るならRAGから始めるよう勧めています。
「AIに学習させる」と「AIに参照させる」は別のこと
RAGではAIそのものを学習し直しません。参照する文書を差し替え、索引に反映されれば、学習し直さなくても答えが変わります。学習させた内容を入れ替えるには、こちら主導で学習し直す必要があります。
公的な資料でも、中身は「探して参照する」仕組みなのに「AIに学習させた」と書かれる例があります。社内では2つの言葉を分けて使うと、費用や情報の扱いの議論がかみ合いやすくなります。
なお、入れた文書をサービス側がAIの改善に使うかどうかは、これとは別の話です。道具ごとの扱いは、後半の表で整理しています。
RAGでできること|社内の活用例と、向いている業務・向かない業務
RAGが力を発揮するのは、答えが社内文書に書いてある質問です。反対に、文書全体の要約や新しい案を出す仕事には向かない場合があります。
| 業務 | RAGに向くか | 理由 |
|---|---|---|
| 就業規則・社内規程への質問 | 向く | 答えが文書にあり、出典で確かめられる |
| マニュアル・手順書の案内 | 向く | 長い文書から該当箇所を探す手間が減る |
| 過去の提案書・議事録の検索 | 向く(文書の整理が前提) | 似た案件や決定の経緯を探しやすい |
| 問い合わせの一次回答の下書き | 向く(人の確認が前提) | 根拠を添えた下書きを作れる |
| 文書全体をまとめる要約 | 向かない | 関係する部分だけを探す仕組みのため |
| 新しい企画や案を出す仕事 | 向かない場合がある | 回答が似た方向にまとまりやすいとされる |
| 計算・集計 | 向かない | 表計算で処理するほうが間違いが起きにくい(当社の見解) |
RAGの活用例
中堅企業の業務に置き換えると、代表的な使い方は次の4つです。
- 社内チャットボット:就業規則や社内規程への質問に、根拠の条文を添えて答える
- マニュアルの案内:「この場合はどうするか」に、該当する手順を示して答える
- 過去の資料の検索:提案書や議事録から、似た案件や過去の決定を探す
- 問い合わせ対応の下書き:一次回答の下書きを作り、担当者が確認して送る
公的機関でのRAGの事例
- デジタル庁:数百ページのマニュアルから、職員がチャット形式で質問し根拠付きの回答を得られるツールを実証しました。令和8年度に各府省庁の職員へ提供するため、実装を進めるとしています
- 神戸市:AI事業者ガイドラインの別添に、事例として「RAGを活用した庁内FAQ等の利用」が載っています
民間でも、令和8年版 情報通信白書によれば、調査に回答した日本企業のうち「社内ヘルプデスク」で生成AIを活用しているのは約5割です。RAGに限った数字ではありませんが、社内の問い合わせは生成AIの使いどころの一つになっています。
RAGに向かない業務
1つ目は文書全体をまとめる要約です。AWSは、文書全体から情報をまとめる用途ではRAGがうまく働かないと書いています。関係する部分だけを探して渡す仕組みだからです。
2つ目は新しい案を出す仕事です。AI事業者ガイドラインの別添は、回答の収束が加速する可能性が高いとして、「コンテンツの多様性・独創性を必要とする業務については、RAGの活用が適切ではない場合もある」としています。
3つ目は計算や集計です。これは当社の見解ですが、正確な数字が要る処理は表計算などで行い、RAGには「どこに書いてあるか」を答えさせるほうが間違いが起きにくいと考えています。
RAGのデメリット・欠点|間違える4つの原因と対策
RAGを使っても、生成AIの間違いはゼロにはなりません。根拠は示しやすくなりますが、元の文書や探し方に問題があれば、もっともらしい誤りが出ます。原因は大きく4つです。
| 原因 | 何が起きるか | 手元の道具でできる対策 | 作るときに確認すること |
|---|---|---|---|
| 関係ない文書を拾う | ずれた文書をもとに外れた答えが出る | 社内の言い回しを文書に足す・文書の言葉で聞き直す | キーワード検索も併用するか |
| 元の文書が古い | 改訂前の規程で答える | 最新版だけを入れる・更新の担当を決める | 更新がいつ索引に反映されるか |
| 見えてはいけない文書が答えに出る | 権限のない人に機密が見える | 閲覧権限を引き継ぐ道具を選ぶ | 役割ごとに参照権限を設定できるか |
| 根拠があっても誤る | 出典付きでも内容や出典が違う | 出典を開いて確かめる・人が確認する | 出典を表示し、評価を続けられるか |
関係ない文書を拾う
Microsoftの解説は、質問と文書で言葉がずれる例を挙げています。「在宅勤務者の有給休暇の規定」を聞いても、文書側は「休み」「テレワーク」と別の言葉で書いている、というずれです。
関係の薄い部分を拾えば、根拠があっても不完全・不正確な答えになり得ます。対策は、社内で使う呼び方を文書に書き足すことと、文書で使われている言葉で聞き直すことです。
元の文書が古い
AI事業者ガイドラインの別添は「RAGの精度は利用する情報に依存する」と明記しています。改訂前の規程が残っていれば、AIはその規程で答えることがあります。
また当社の見解として、同じ内容が何か所にもあったり、古い版と新しい版が混ざっていたりすると、答えが揺れやすくなります。最新版だけを入れ、文書ごとに更新の担当を決めておきましょう。
見えてはいけない文書が答えに出る
Microsoftは、アクセス管理をしないと、根拠付きの回答が機密情報を漏らし得ると注意しています。財務のデータは、役員がチャットボットに尋ねても財務チームだけが見られるようにすべき、という例です。
デジタル庁の生成AIの調達・利活用に係るガイドライン(第2.0版・2026年6月12日)も、調達チェックシートの対策例として「RAG用のデータ及びデータストアへの参照権限をユーザーや役割に応じて適切に設定する」ことを調達のチェック項目にしています。
根拠があってもハルシネーションは起こる
ハルシネーションは、もっともらしいが事実と違う文章をAIが作ることです。OpenAIは、すべての大規模言語モデルに共通する根本的な課題だとし、Microsoftも文書を根拠に渡しても起こり得ると明記しています。
Googleも、出典を示していても間違え、実在しない出典を示す場合があると書いています。出典を開いて元の文書と照らし合わせ、人事や契約などの判断は人が確認する前提で使いましょう。
RAGを手元の道具で試す方法|Gemini Notebook(旧NotebookLM)・ChatGPT・ドライブ
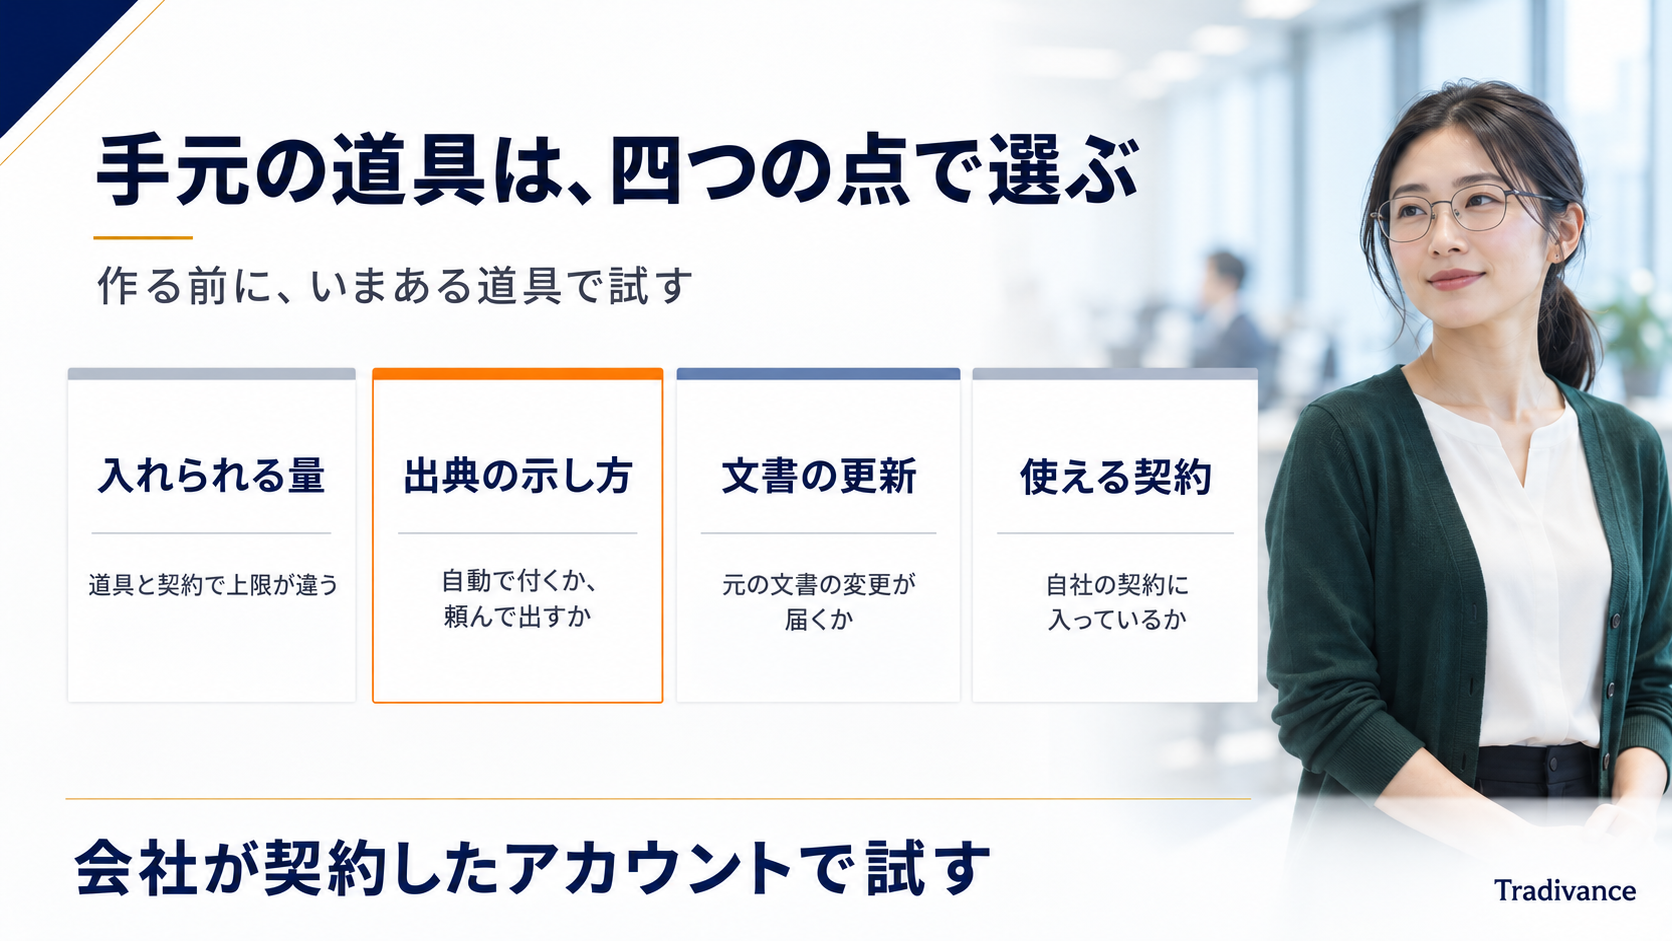
RAGは、仕組みを作らなくても今ある道具で体験できます。2026年10月時点の公式ヘルプで確認できた内容を比べました。
| 道具 | 入れられる量 | 出典の表示 | ドライブの文書の同期 | 使えるプラン | 入れたデータの扱い |
|---|---|---|---|---|---|
| Gemini Notebook(旧 NotebookLM) | 1ノートに無料50件・Plus 100件・Pro 300件・Ultra 500〜600件(1件50万語または200MBまで) | 回答に引用が付き、元の箇所へ移動できる(資料がとても短いときは、文書全体を参照する形になる) | 数分おきに自動で同期 | 無料から。Workspaceは Business Starter で50件、Business Standard 以上で300件 | Workspaceの標準機能として使うエディションでは、人が見たりAIの改善に使ったりしない |
| ChatGPTのプロジェクト | 1プロジェクトに Free 5件・Go/Plus 25件・Pro/Business/Enterprise/Edu 40件 | 指示すれば出させられる(自動で付くかは、確認できた公式ヘルプに記載なし) | 同期されない | Freeから | Business/Enterprise/Eduは既定で学習に使わない。Free/Plus/Proは設定がオンだと使われ得る |
| Googleドライブの Ask Gemini | 件数の公式記載なし(多すぎると一部しか読まないことがある) | 文末の[1]などの番号でファイルを確かめられる | ドライブのファイルを直接ソースに指定 | Business Standard 以上(Business Starter は対象外)、個人は Google AI Pro/Ultra | ※ |
※Ask Geminiを名指ししたデータの扱いの記載は見当たらないため空欄にしています。Workspaceの対象エディションでは、許可なく人が確認したり、ドメイン外のAIの学習に使ったりしないとされています。
なお、Microsoft Copilotも社内の文書やメールを根拠に答える、RAGと同じ考え方の仕組みで、使う社内データは本人が閲覧権限を持つものに限られます。
Gemini Notebook(旧 NotebookLM)で試す
Googleの公式ブログによると、NotebookLMは2026年7月16日にGemini Notebookへ名称が変わり、独立した製品として提供が続いています。ヘルプは、資料が多いときは質問に関係する情報を探し、そこから答えを組み立てると説明しており、まさにRAGの動きです。
ドライブから入れた文書は自動で同期されるため、規程を直せばノートも追いつきます。回答は基本は入れた資料をもとに答える設計ですが、資料なしで使えるチャット機能も加わったので、回答に引用が付いているかを確かめてください。ただし、Web検索やファイルの作成などの機能は、プランによって使える範囲が違う場合があります。
資料から新しいファイルを作る機能もあり、「入れて聞く」だけでなく「作って出す」使い方もできます。Workspaceでのプラン別の違いとデータの扱いは、「Google Workspace × Gemini Notebook(旧 NotebookLM)の解説」で扱っています。
ChatGPT の「プロジェクト」で試す
ChatGPTでは、「プロジェクト」にファイルを入れて質問します。Googleドキュメントは、PDFかDOCXに書き出してから入れましょう。
注意したいのは、プロジェクトにドライブを追加しても、中身が前もって同期されるわけではないことです。書き出して入れたファイルは、規程を直したら入れ直す運用になります。
出典は、「どの文書のどこにあるか示して」と頼むと確かめやすくなります。
Googleドライブの「Ask Gemini」で試す
ドライブの「Ask Gemini」は、フォルダやファイルをソースに指定して質問できます。Business Starterは対象外なので、契約中のエディションを先に確かめてください。違いは「Business Standardとは」で整理しています。
ソースに使えるのは、本人が閲覧権限を持つファイルだけです。一方でGoogle自身が、出典を示していても間違えることがあると書いているため、番号から元のファイルを開いて確かめます。
RAGの始め方|社内で小さく試して、効果を測ってから広げる
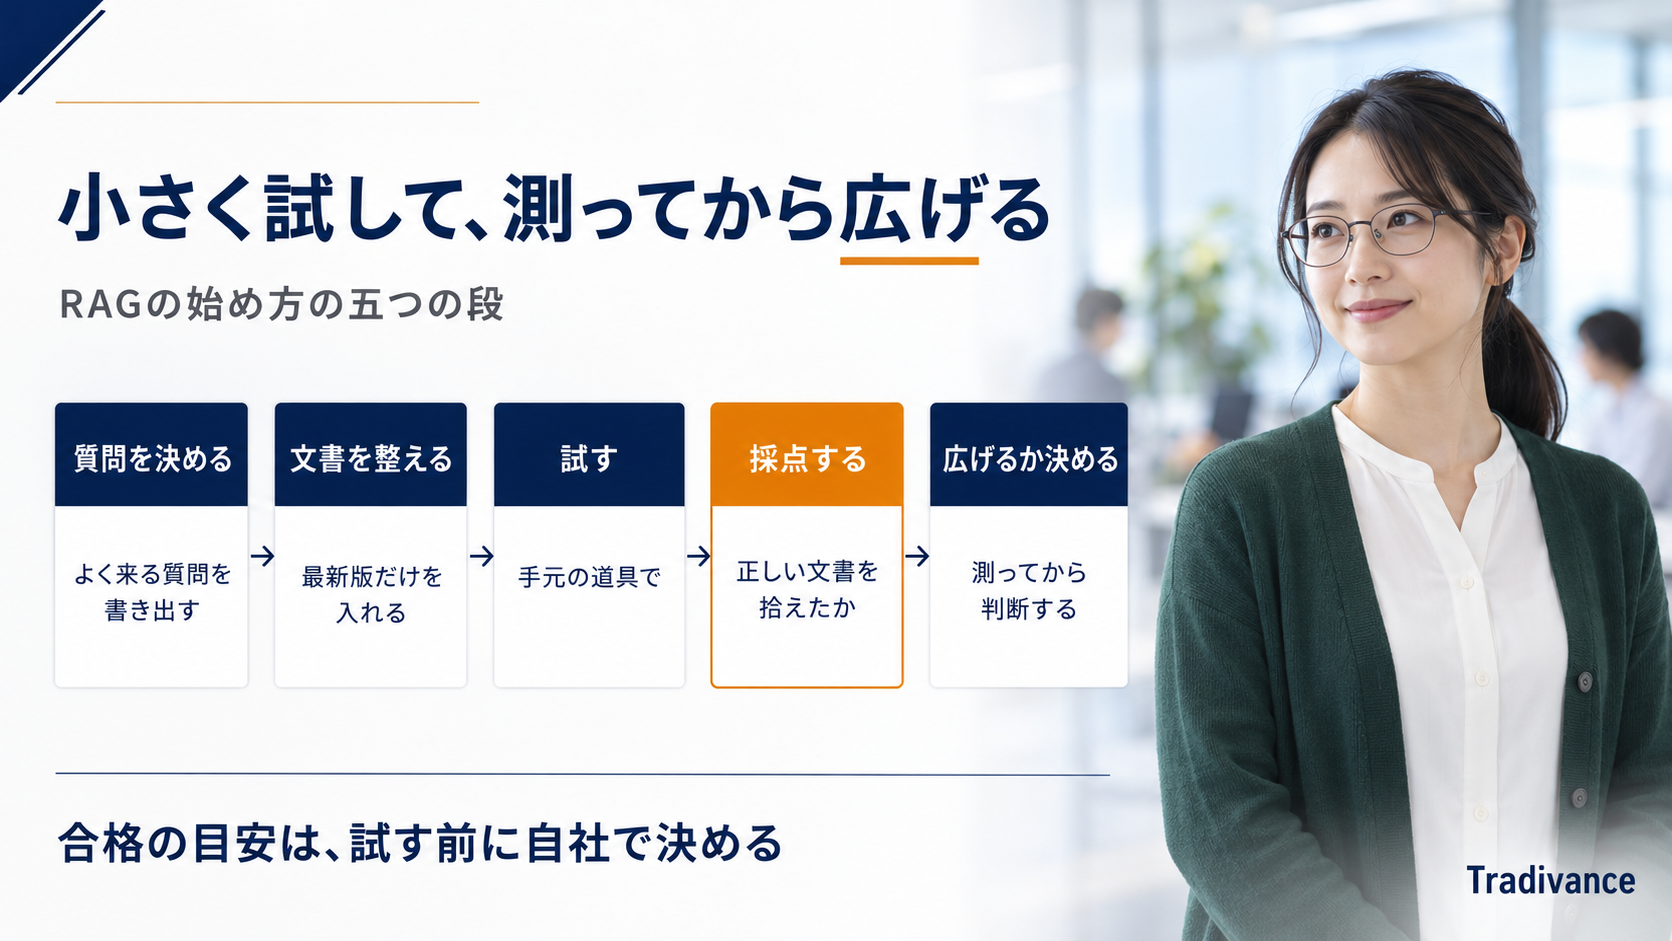
RAGは、いきなり仕組みを作るより、1つの業務で小さく試し、答えを採点してから広げるのが近道です。次の5つのステップで進めます。
使う業務と、よく来る質問を20個決める
社内規程や手順書への問い合わせのように、答えが文書に書いてある業務を選びます。
よく来る質問を20個ほど書き出し、正しい答えと根拠の箇所も一緒にメモしておくと、後の採点の問題集になります。
文書を集めて整える
最新版だけを残し、同じ内容は1つにまとめ、誰が見てよい文書かを分けましょう。最初は全社員が見てよい文書から始めると、権限の心配が少なく済みます。
手元の道具で試す
前の章の道具から自社の契約に合うものを選び、20個の質問をします。
会社が契約した業務用のアカウントで試し、個人の無料アカウントに社内の文書を入れないようにします。データの扱いがプランで違うためです。
答えを採点する
デジタル庁のリスク対策ガイドブック(α版)が例として挙げるRAGの評価の観点のうち、主なものを言い換えると次の4点です。
- 正しい文書を拾えたか:想定していた箇所を見つけているか
- 関係ない文書が混ざっていないか
- 固有名詞が文書にあるか:答えの人名や制度名が文書に書いてあるか
- 答えが文書に書いてあるか:答えの内容が、文書で述べられていることか
広げるか、仕組みを作るかを決める
採点の結果から、対象を広げるか、仕組みとして作るかを決めます。外れた質問は、文書の不足か、言い回しのずれか、権限の問題かに振り分けると、次に直す場所が見えます。
RAGの効果の測り方
効果は「便利になった気がする」ではなく、試す前に決めた物差しで測りましょう。当社では、次の4つを見ることをおすすめしています。
| 何を見るか | どう確かめるか | 目安の決め方 |
|---|---|---|
| 正答率 | 20個の質問のうち、正しく答えた数を数える | 試す前に、許せる水準を社内で決める |
| 出典が正しいか | 出典を開き、根拠が書いてあるかを確かめる | 出典違いを不正解とするか決めておく |
| 探す時間がどれだけ減ったか | 従来の探し方とRAGで、かかった時間を比べる | 現場で実感できる差かで判断する |
| 答えられなかった質問の数 | 答えられなかった質問と外れた質問を数える | 文書を足して減るかを次の試しで確かめる |
確認した公的資料に、正答率などの数値の目安は示されていません。目安は、業務の重さに合わせて自社で決めます。規程の案内と、お金や契約に関わる回答では、求める水準が違うためです。
RAGを自社で構築するか、製品を使うか|判断の目安と最新の動き
手元の道具で答えが当たり、広げたい範囲が見えてから、製品を使うか自社で構築するかを決めるのが順当です。進め方ごとの向き不向きは次のとおりです。
| 進め方 | 向く状況 | 準備するもの | 費用がかかるところ |
|---|---|---|---|
| 手元の道具で使う | 文書が少なく、使う人も限られる | 整えた文書と業務用のアカウント | 道具のライセンス |
| RAGの製品(社内向けチャット等)を使う | 部署をまたいで使い、権限や管理の機能が要る | 文書の置き場所の整理、権限の設計、運用の担当 | 製品の利用料と導入作業 |
| クラウドで構築する | 社内の他の仕組みとつなぎ、答え方を細かく調整したい | 上の準備に加え、開発と保守の体制 | 検索・埋め込み・渡す文字数の分の費用と待ち時間、開発と保守 |
RAGの費用としてMicrosoftは、検索と埋め込みにかかる費用と待ち時間、AIに渡す文章が増える分の費用を挙げています。金額は規模と設計で大きく変わるため、見積もりで確かめてください。
RAGの最新の動き
2024年2月にはMicrosoft ResearchがGraphRAGを発表し、同年7月に公開しました。文書の中の物事のつながりを整理し、文書全体にまたがる問いに答えやすくする工夫です。
またMicrosoftは、Azure AI Searchの解説で、新しくRAGを作るなら「エージェント型の検索」から始めるよう勧め、従来型をclassic RAGと呼んでいます。エージェントの考え方は「AIエージェントとは」で解説しているので、そちらをご覧ください。
RAGを自社で構築するときに決めること
どの方式でも、元の文書と権限が整っていなければ、答えは当たりにくくなります。製品を使う場合も、次の4つは最初に決めておきます。
- 文書の置き場所:どの文書を対象にし、最新版をどこに置くか
- 権限の引き継ぎ:元の文書の閲覧権限を、答えにも反映できるか
- 更新の担当:文書を改訂したとき、誰がいつ差し替えるか
- 評価のやり方:どの質問で、何を見て、どの頻度で採点するか
外部の支援を使うかどうかの判断は、「AI導入支援会社の選び方・費用相場」で整理しています。
RAGとは?よくある質問(FAQ)
RAGの読み方は?何の略ですか?
「ラグ」と読みます。Retrieval-Augmented Generationの略で、日本語では「検索拡張生成」と訳されます。
生成AIが答える前に、社内の文書などから関係する部分を探し、それを手がかりに答えを作る仕組みを指します。
LLMとRAGの違いは何ですか?
LLM(大規模言語モデル)は、答えの文章を作る生成AIの中心の部品です。RAGは、LLMの前に文書を探す工程を足した使い方で、LLMと置き換わるものではありません。
答えを作るのはLLMで、RAGはLLMに渡す材料をそろえる役割を担います。
ChatGPTとRAGの違いは何ですか?
ChatGPTはLLMを使った会話のサービスで、Web検索を使わないときは学習した時点までの情報で答えます。RAGは、社内の文書などを探してから答える仕組みの名前です。
ChatGPTも、「プロジェクト」にファイルを入れて質問すれば、RAGに近い使い方ができます。
RAGの欠点は何ですか?
間違える原因は主に4つです。関係ない文書を拾う、元の文書が古い、見えてはいけない文書が答えに出る、根拠があっても誤る、の4つです。
また、文書全体をまとめる要約や、新しい案を出す仕事には向かない場合があるとされています。
RAGを使えばハルシネーションはなくなりますか?
なくなりません。Microsoftは、文書を根拠に渡しても不正確な答えは起こり得ると明記しています。
出典を開いて元の文書と照らし合わせる運用と、大事な判断を人が確認する前提で使うことをおすすめします。
社内の文書を入れると、AIの学習に使われますか?
道具とプランで違います。たとえばChatGPTは、Business・Enterprise・Eduでは既定で学習に使われませんが、Free・Plus・Proでは設定がオンだと使われる場合があります。
会社が契約した業務用のアカウントで試し、本文の「手元の道具で試す方法」の表で各道具の扱いを確かめてください。
RAGはどうやって作りますか?
最初から作る必要はありません。よく来る質問を20個決め、文書を整え、Gemini Notebookなどの手元の道具で試して採点するところから始めます。
広げたい範囲が見えてから、製品を使うか自社で構築するかを決める進め方をおすすめします。
RAGを社内で使う前に
まとめ|RAGは「文書を整えて、手元で試してから」広げる
RAGは、生成AIに「調べてから答える」工程を足す仕組みです。答えの質は、仕組みより元の文書と探し方で大きく変わります。
本記事の要点
- RAGとは:生成AIが社内の文書などを探してから答える仕組み
- 答えの質と安全を左右するもの:元の文書の新しさと整理、閲覧権限の設計
- まず試す:手元の道具に整えた文書を入れ、20個の質問で採点する
- 広げ方:測った結果を見てから、製品か構築かを決める
製品の名前や上限は、Gemini Notebookへの改称やGPTsの廃止予定のように動きが早いため、試す前に公式の最新の記載を確かめてください。
また、間違いはゼロにならないため、出典を確かめる運用と、人が確認する場面を最初から決めておくことが大切です。
まずは、社内でよく来る質問を20個書き出してみてください。それが、RAGを試す問題集にも、効果を測る物差しにもなります。
もし「今の使い方を見直したい」「今後の事業の広がりも見据えてきちんと検討したい」「どこから手をつければよいか分からない」という方は、お気軽に当社へご相談ください。これまでの実績や活用事例とあわせてご説明します。